00 · Modelo mental
Qué es OhMyBrain y la regla de oro
Antes de tocar un botón: de dónde lee, qué no hace nunca y por qué todos los números son reproducibles.
OhMyBrain es el módulo de análisis de OhMyDat. No es un conector en vivo: trabaja sobre una copia DuckDB (un fichero .duckdb) que genera OhMyExtract a partir de tu programa de gestión. El chat, el explorador, los KPIs, los cuadros, los informes y las previsiones consultan esa copia, nunca la base de datos de producción.
1 · Fuente de análisis
Un conector marcado como «Extracción de datos para análisis». Solo puede haber uno por empresa.
/brain/connectors2 · Copia extraída
El .duckdb firmado con SHA-256 que deja la última extracción correcta en S3.
connectors.last_extract_s3_uri3 · Capa de negocio
El catálogo canónico traduce tablas y columnas físicas a indicadores, desgloses y KPIs humanos.
catalogo-canonico.ts/brain/dashboard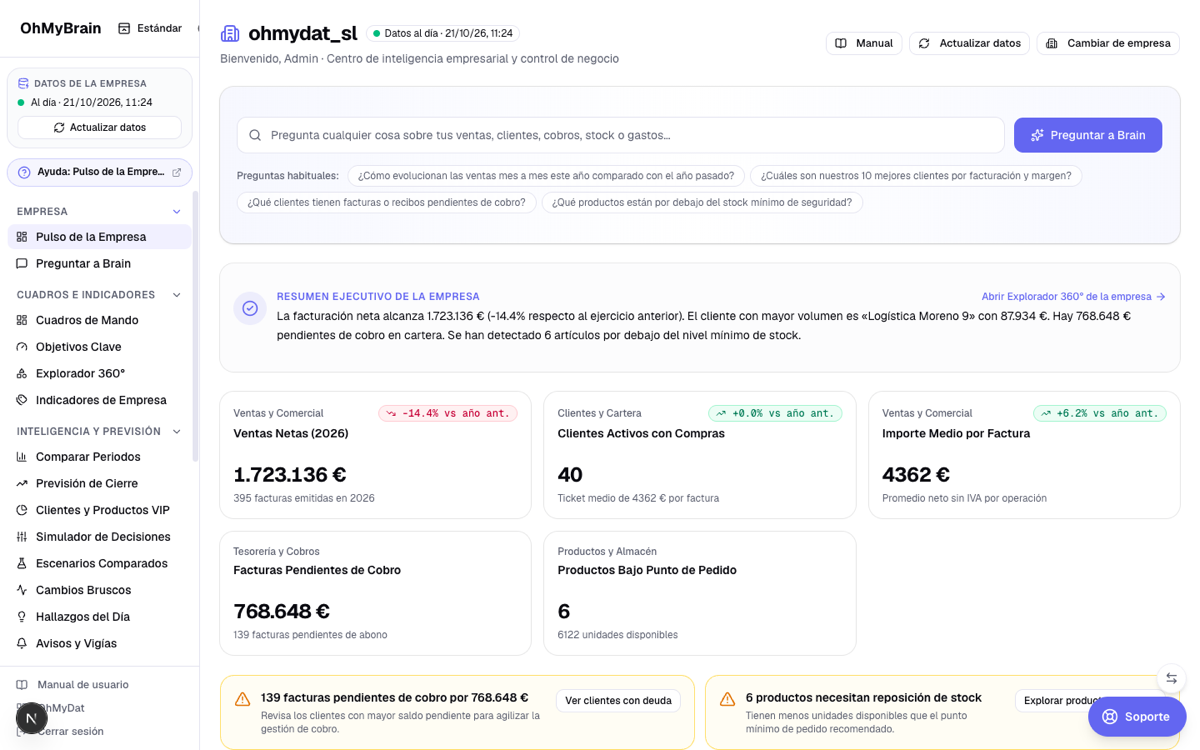
Lo que sí hace
- Leer la copia con SQL de solo lectura.
- Repetir cualquier número: la consulta y su huella quedan registradas.
- Enseñar la frescura y la calidad del dato junto al resultado.
Lo que no hace
- No escribe en tu ERP ni en la copia (el guard rechaza DML/DDL).
- No es tiempo real: el retardo es el de la última extracción.
- No inventa un resultado si no hay fuente o extracción: devuelve un 409 explicando qué falta.
La frase que resume el módulo
De dónde salen estos datos
src/brain/lib/datos/fuente-analisis.ts: un único conector con is_analysis_source = true, activo, en modo OhMyExtract y con la última extracción en success. De ahí salen la URI del artefacto, su SHA-256, el tamaño y la fecha (lastExtractedAt). Si falta cualquiera de esas piezas, no hay análisis: se responde con el código BRAIN_SIN_FUENTE_ANALISIS o BRAIN_SIN_EXTRACCION.- API
- GET /api/catalogo · GET /api/catalogo/explorar?modo=pulso · POST /api/ai/chat
- BD
- connectors (is_analysis_source, last_extract_*), extract_jobs, brain_data_quality
- Fichero
- uploads/extracted/<clave S3>.duckdb · _resumen_extraccion
01 · Puesta en marcha
Primeros pasos: Demo SL, conectar la fuente y primera extracción
Dos caminos: probar con datos ficticios en un clic o conectar tu gestión. En ambos, el final es el mismo: una copia .duckdb utilizable.
Prueba con Demo SL (datos 100 % ficticios)
/brain/demoGenera un artefacto DuckDB con clientes, productos, facturas del ejercicio anterior y del actual, cobros, stock y horas. No toca tu ERP y puedes reinstalarla cuando quieras.
/brain/demo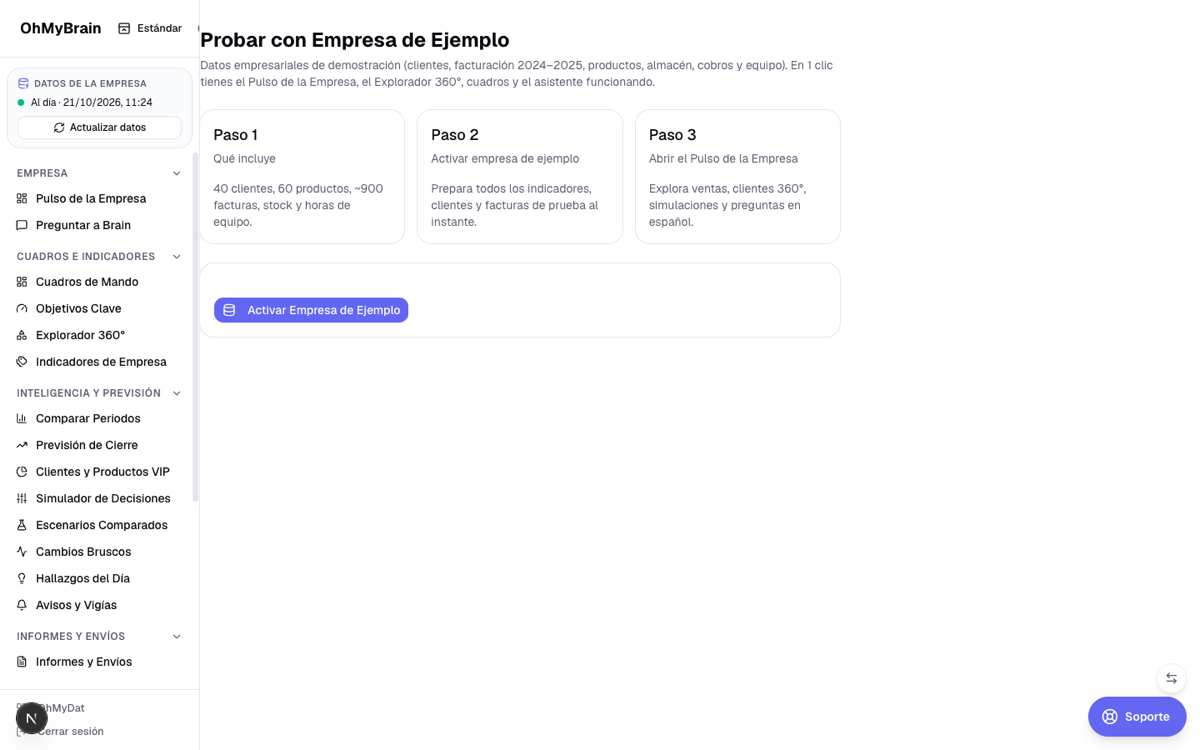
Conecta tu programa de gestión
/brain/connectorsElige plantilla (XGestEvo, Sage 50, Odoo, Holded, Factusol, A3ERP, PrestaShop, WooCommerce…) o tipo de origen (PostgreSQL, MySQL, SQL Server, Oracle, Firebird, SQLite, CSV, API…). Rellena credenciales y pulsa Probar conexión.
/brain/connectors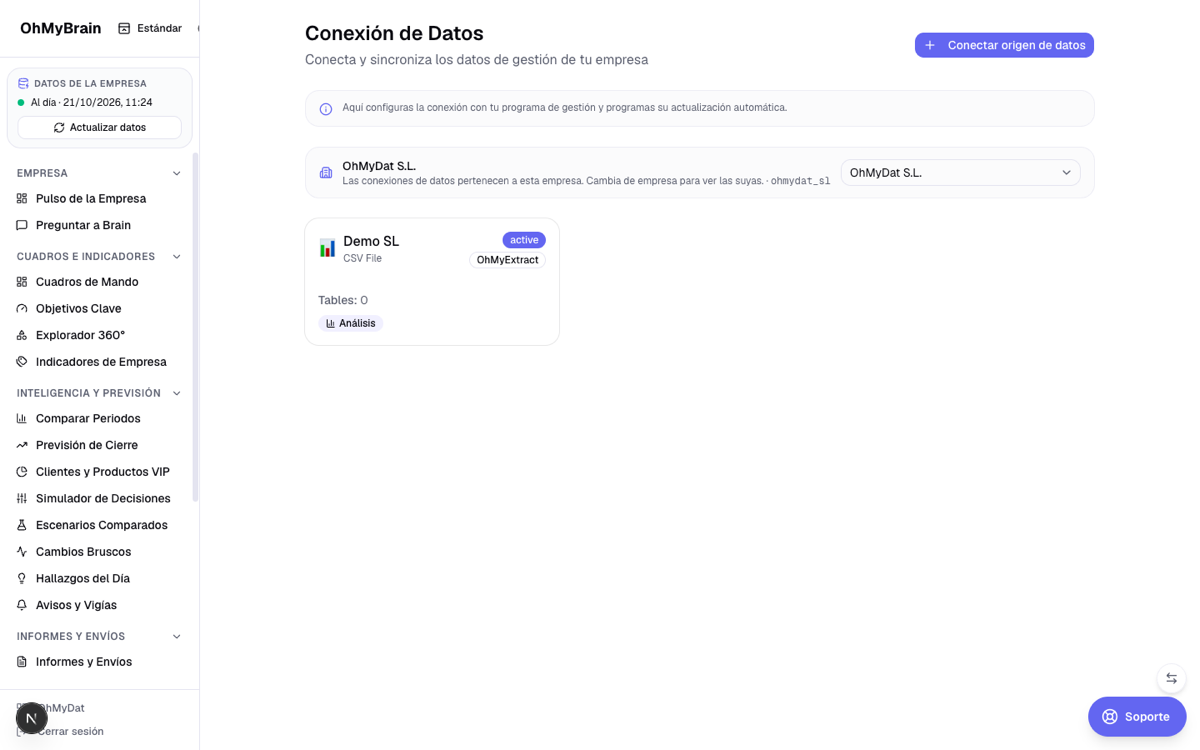
Marca la fuente de análisis y ejecuta la extracción
En la ficha del conector, activa «Extracción de datos para análisis» y pulsa Extraer ahora (o define la programación cron). El estado pasa por pending → running → success/failed; al terminar, la copia queda firmada y disponible.
Revisa la capa semántica (opcional)
/brain/connectors/[id]/templateLa plantilla de conversión dice qué tabla del origen acaba en qué tabla canónica. No es obligatoria: si no la defines, el catálogo canónico se construye solo a partir de las tablas reales de la copia.
Usa un usuario de solo lectura en el origen
La demo no es un juguete aparte
De dónde salen estos datos
extract_mode = ohmyextract, last_extract_status = success y last_extract_s3_uri = file://…. En una empresa real, el artefacto lo produce OhMyExtract y la ficha del conector guarda su URI, tamaño, firma y fecha; el job deja filas y duración en extract_jobs.- API
- POST /api/demo/install · POST /api/connectors/[id]/extract · GET /api/connectors/health
- BD
- connectors, extract_jobs, connector_tables, field_mappings
- Fichero
- uploads/demo/demo-sl.duckdb (demo) · S3 o file:// con la copia real
Mapa de navegación completo: el menú lateral agrupa las pantallas en Empresa, Cuadros e indicadores, Inteligencia y previsión, Informes y envíos, Conocimiento y Configuración. En este manual se recorren en ese mismo orden.
| En el menú | Ruta | Para qué |
|---|---|---|
| Pulso de la Empresa | /brain/dashboard | Resumen diario y avisos accionables |
| Preguntar a Brain | /brain/threads | Preguntas en español y SQL |
| Cuadros de Mando | /brain/dashboards | Cuadros por departamento |
| Objetivos Clave | /brain/kpis | KPIs con objetivo y umbrales |
| Explorador 360° | /brain/catalogo | Cruzar indicadores y fichas |
| Indicadores de Empresa | /brain/metricas | Diccionario de métricas |
| Comparar Periodos | /brain/analysis/compare | Dos periodos cara a cara |
| Previsión de Cierre | /brain/analysis/forecast | Pronóstico con bandas |
| Clientes y Productos VIP | /brain/analysis/segments | ABC y RFM |
| Simulador de Decisiones | /brain/analysis/what-if | Escenarios sin tocar datos |
| Escenarios Comparados | /brain/analysis/escenarios | Guardar y comparar análisis |
| Cambios Bruscos | /brain/analysis/anomalies | Picos y caídas |
| Hallazgos del Día | /brain/analysis/insights | Observaciones guardadas |
| Avisos y Vigías | /brain/alertas | Reglas que vigilan por ti |
| Informes y Envíos | /brain/reports | Informes con secciones |
| Presentaciones | /brain/presentaciones | Storytelling de reunión |
| Envíos por Correo | /brain/suscripciones | Suscripciones programadas |
| Consultas guardadas | /brain/queries | Preguntas reutilizables |
| Plantillas | /brain/templates | Consultas parametrizadas |
| Documentos | /brain/documents | PDF, Word, Excel y CSV |
| Conexión de Datos | /brain/connectors | Fuentes y extracciones |
| Configuración | /brain/settings | Empresa, equipo y enlaces |
| Playground SQL | /brain/playground | SELECT gobernado |
Modo MDI: varias pantallas a la vez
02 · Empresa
Pulso de la Empresa: el resumen que se lee en 30 segundos
La pantalla de entrada. No es un cuadro más: es la respuesta a «¿cómo va la empresa?» con cuatro tarjetas, una evolución y avisos que llevan a la acción.
Ventas y comercial
Ventas del año, comparación con el año anterior y facturas emitidas.
Clientes y cartera
Clientes activos con compras y ticket medio por factura.
Tesorería y cobros
Facturas pendientes de cobro y su importe.
Productos y almacén
Artículos bajo punto de pedido y unidades disponibles.
Cada tarjeta lleva su variación vs año anterior y un enlace al detalle. El bloque «Resumen ejecutivo» resume en dos frases lo que está pasando (la facturación, el cliente con más volumen y la deuda pendiente) y los avisos de la parte inferior son accionables: «Ver clientes con deuda», «Explorar productos».
Empieza por la fecha y la fuente
Arriba, junto al nombre de la empresa, se ve la fuente activa y «Al día» con la fecha y hora de la última extracción. Si esa fecha no es la que esperabas, el resto de la pantalla está contando una foto antigua.
Actualizar datos
«Actualizar datos» lanza una extracción en tiempo real de los conectores OhMyExtract activos: vuelve a leer el ERP y regenera la copia. Tarda según el tamaño; al terminar, las cifras se recargan solas. Si solo quieres repintar sin extraer, recarga la página.
De dónde salen estos datos
.duckdb. La fecha que se pinta es connectors.lastExtractedAt, no la hora de la consulta.- API
- GET /api/catalogo/explorar?modo=pulso
- BD
- connectors, kpi_snapshots, brain_data_quality
- Fichero
- artefacto .duckdb + _resumen_extraccion
Si el pulso sale vacío
03 · Chat
Preguntar a Brain: español dentro, SQL auditado fuera
La puerta principal. Escribes una pregunta de negocio y ves la respuesta, la tabla, el gráfico y la consulta exacta que se ejecutó.
/brain/threads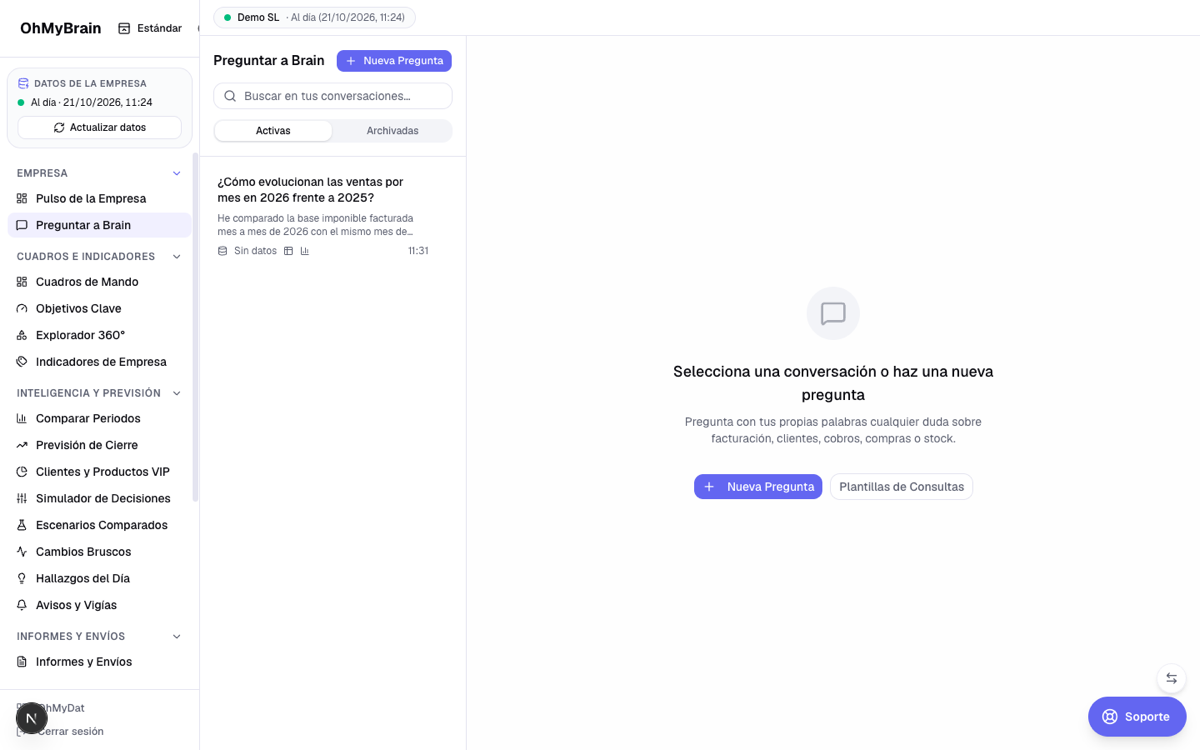
Pregunta en tu idioma de negocio
/brain/threads/new«¿Cómo evolucionan las ventas por mes en 2026 frente a 2025?», «top 10 clientes por margen del último trimestre», «qué facturas vencidas superan los 1.000 €». No hace falta nombrar tablas ni columnas.
Lee la respuesta, no solo el número
Cada respuesta trae un texto ejecutivo, los datos en tabla y un gráfico inferido. El botón «Ver origen» abre el linaje: huella SHA-256 de la consulta, tablas tocadas, artefacto del que salió, filas, milisegundos y modelo usado.
Sigue preguntando en el mismo hilo
Los follow-ups («y ahora solo Madrid», «compáralo con el año pasado») usan el contexto anterior. Cuando el hilo crece, el contexto se resume para no disparar tokens: no se pierde el tema, se recorta la transcripción.
Guarda lo que funciona
/brain/queriesUna pregunta útil se guarda con nombre y dueño. Queda versionada y reutilizable, y se puede convertir en KPI, widget o apartado de informe.
/brain/threads/[id]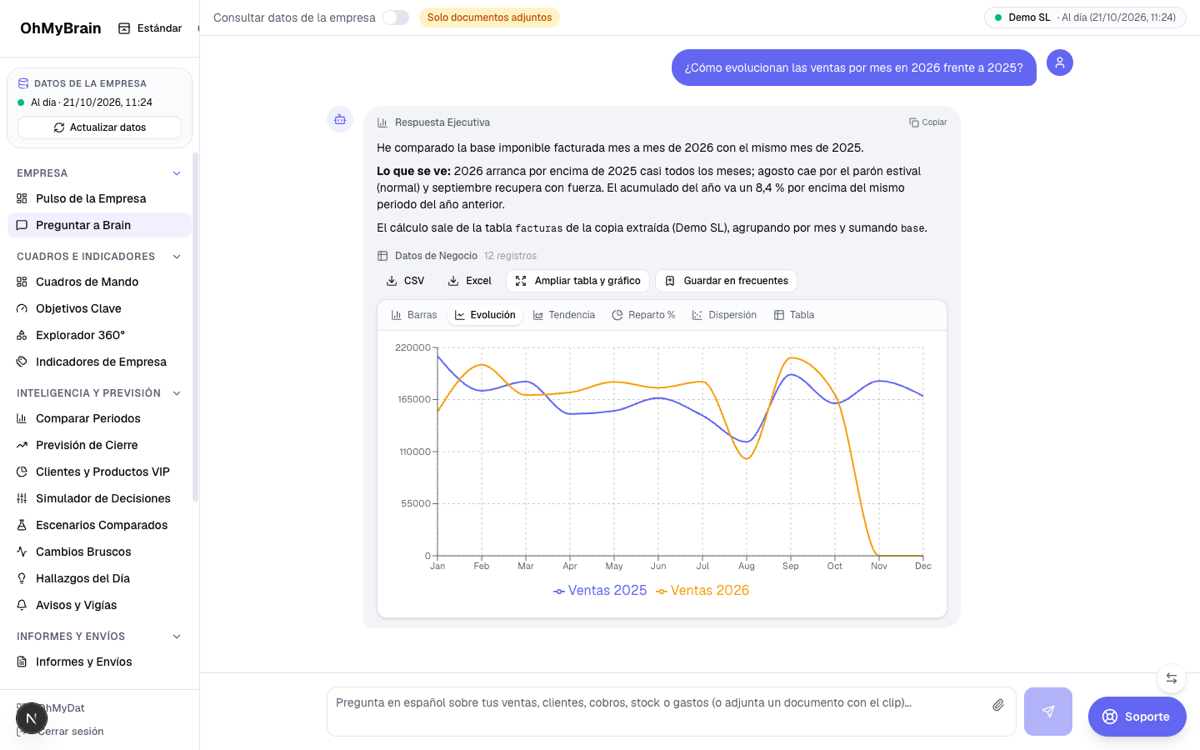
El SQL no es una caja negra
El modo «Solo documentos adjuntos»
El interruptor «Consultar datos de la empresa» decide si la pregunta toca la copia extraída. Apagado, el chat responde únicamente con los documentos que adjuntes (contratos, pliegos, actas) y cita las fuentes. Encendido, consulta los datos y puede combinar ambos contextos.
De dónde salen estos datos
threads y thread_messages. El linaje lee brain_query_log por la huella SHA-256 de la consulta.- API
- POST /api/ai/chat · GET /api/linaje?sqlHash= · GET /api/threads/[id]
- BD
- threads, thread_messages, brain_query_log, documents, embeddings, brain_semantic_metrics
- Fichero
- artefacto .duckdb · uploads/documents/…
Si el chat responde 503
OPENAI_API_KEY, OPENROUTER_API_KEY…) y de qué capa sale (empresa, BD del panel o .env). Con la BD por encima del .env, corregir solo el fichero no cambia nada: hay que corregir el valor del panel.04 · Explorar
Explorador 360°: cruzar indicadores sin escribir SQL
La tabla dinámica visual del módulo. Eliges qué medir, cómo agrupar, en qué periodo y filtras por nombre; el resultado se dibuja al instante y se puede descargar.
/brain/catalogo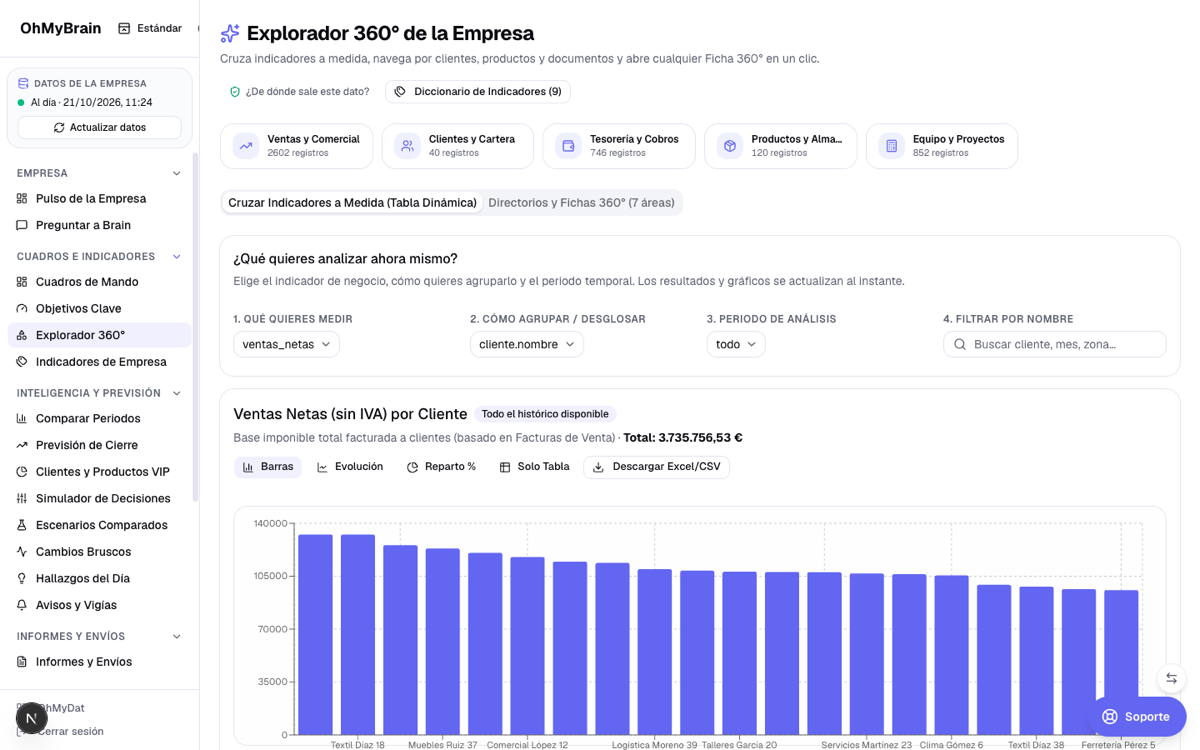
Elige el área de negocio
Ventas y comercial, Clientes y cartera, Tesorería y cobros, Productos y almacén, Equipo y proyectos. Cada tarjeta muestra el número de registros disponibles y solo aparece si hay datos.
Indicador + desglose + periodo
El indicador es una métrica con fórmula (ventas netas, margen, pendiente de cobro…). El desglose es una dimensión humana (cliente, zona, familia, mes). El periodo filtra por el calendario del negocio (año actual, último trimestre, todo…).
Ficha 360° y descarga
«Directorio y Fichas 360°» cambia la tabla dinámica por el listado de clientes, productos o proveedores; al abrir uno se ve su ficha completa (compras, deuda, productos habituales, últimas facturas). Cualquier resultado se descarga en Excel/CSV.
La interfaz nunca enseña nombres físicos
facturas_venta ni cli_nom: el catálogo canónico traduce tablas y columnas a conceptos de negocio. Es la misma capa que usan el chat, los KPIs y los cuadros, así que los números coinciden entre pantallas.De dónde salen estos datos
_resumen_extraccion. El explorador compone el SQL con el constructor de negocio y lo ejecuta contra el artefacto. Los perfiles y la calidad del dato se leen de brain_data_profiles y brain_data_quality, que se recalculan en cada extracción.- API
- GET /api/catalogo · POST /api/catalogo/explorar · GET /api/catalogo/explorar?modo=ficha_cliente
- BD
- brain_data_profiles, brain_data_quality, connectors
- Fichero
- artefacto .duckdb + _resumen_extraccion
05 · Diccionario
Indicadores de Empresa: qué significa cada métrica
El diccionario de negocio. Cada indicador declara su fórmula SQL, su tabla base, su formato y quién lo ha certificado.
El catálogo canónico se construye solo
OhMyBrain reconoce las tablas de tu extracción (facturas, albaranes, pedidos, clientes, artículos, cobros, stock, contabilidad, horas…) y genera más de 60 indicadores con sus dimensiones, KPIs, cuadros preconfigurados y preguntas frecuentes. No hay que escribir un JSON ni una línea de SQL para empezar. Si tu empresa trae una plantilla semántica v2, sus definiciones mandan y el catálogo automático solo rellena huecos.
Lee la fórmula antes de fiarte
Cada métrica muestra su fórmula exacta y su explicación en español («base imponible total facturada»). El chat usa esa fórmula cuando la pregunta menciona la métrica: no hay dos definiciones de «ventas netas» conviviendo.
Certifica lo que vayas a usar en dirección
Los estados son borrador → certificado → archivado. Certificar significa que un humano ha revisado la fórmula; el guard de negocio la impone en el SQL y la certificación se propaga al modelo. No certifiques lo que no hayas leído.
Comprueba el origen del dato
Antes de publicar un indicador, abre el explorador y comprueba que la tabla base tiene datos y frescura. Una fórmula correcta sobre una copia de hace dos semanas sigue siendo una foto vieja.
De dónde salen estos datos
brain_semantic_*, con versiones y certificación) y la automática (el catálogo canónico que se deriva de las tablas/columnas del artefacto en cada lectura). Las dos se fusionan: la explícita manda y la automática rellena lo que falte.- API
- GET /api/semantic/models · GET /api/semantic/models/[id] · POST /api/ai/chat
- BD
- brain_semantic_models, brain_semantic_metrics, brain_semantic_dimensions, brain_semantic_relations, brain_semantic_glossary, brain_semantic_rules, brain_semantic_versions, brain_semantic_kpis
- Fichero
- catalogo-canonico.ts (generación) · plantillas/*.json (v2 opcional)
Métrica certificada no es métrica verdadera
06 · KPIs
Objetivos Clave: metas, umbrales y semáforos
Un KPI es una métrica con objetivo y umbrales, evaluada periódicamente por un worker contra la copia. El panel muestra el último valor, su semáforo y si ha disparado avisos.
/brain/kpis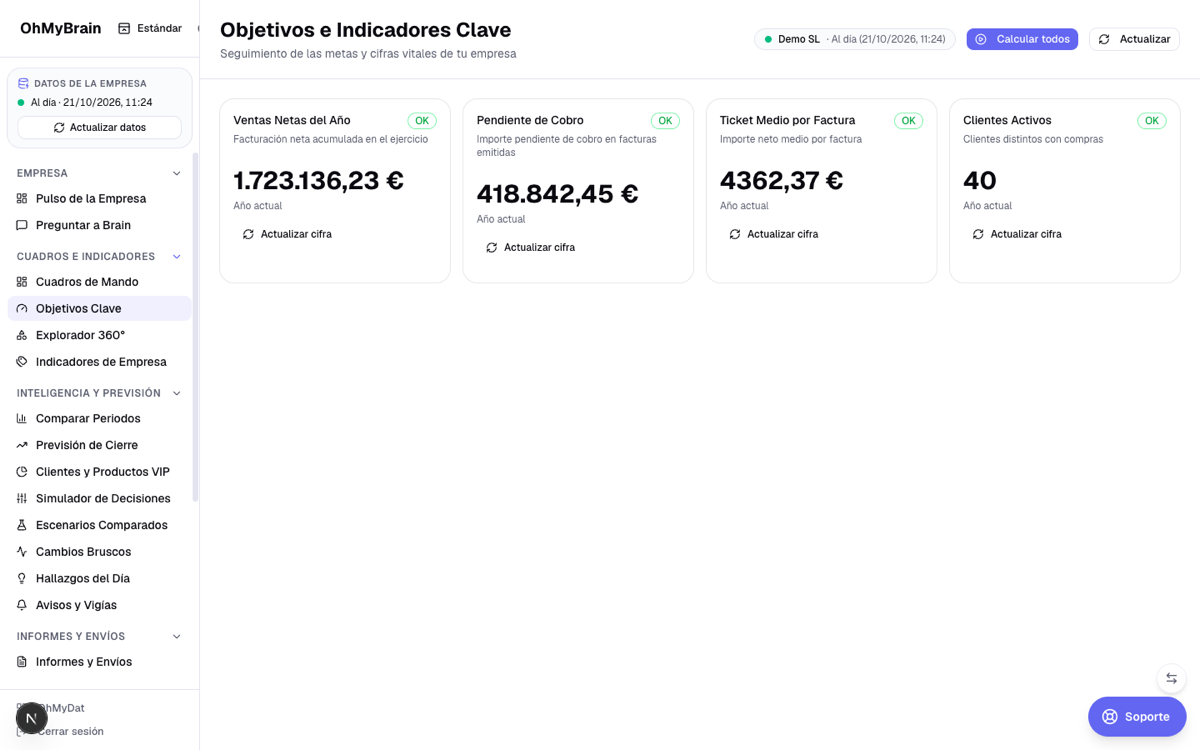
Métrica
La fórmula del diccionario (por ejemplo, SUM(base) sobre facturas).
Periodo
El filtro temporal del KPI: año actual, mes actual, todo…
Umbrales
Warning y critical; la dirección decide si subir o bajar es bueno.
Elige el KPI y mira el valor actual
/brain/kpisCada tarjeta muestra valor, semáforo (OK / aviso / crítico), periodo y la hora del último snapshot. «Actualizar cifra» encola una evaluación inmediata.
Abre la ficha para el detalle
/brain/kpis/[plantilla]/[kpiId]La ficha reúne valor actual, histórico de snapshots, umbrales, alertas asociadas y tres accesos: añadir a un cuadro, programar un aviso y refrescar.
Ajusta el objetivo sin tocar la fórmula
El objetivo y los umbrales se pueden sobreescribir por empresa o por KPI: cambias la meta, no el cálculo. La fórmula sigue siendo la misma que usan el chat y los cuadros.
De dónde salen estos datos
POST /api/kpis/refresh-all (que reparte los KPI con jitter para no saturar DuckDB). Resuelve la fuente, carga la capa semántica, construye el SQL con la fórmula + filtro temporal + reglas obligatorias y lo ejecuta contra el artefacto. Guarda un KpiSnapshot con valor, periodo, duración y estado. No hay una pasada periódica de KPIs programada por defecto: el scheduler se ocupa de informes, alertas y purga. Si el valor cruza un umbral, se crea un KpiAlertEvent solo en la transición, con un cooldown de 60 minutos.- API
- GET /api/kpis · POST /api/kpis/refresh · POST /api/kpis/refresh-all · GET /api/kpis/snapshots
- BD
- kpi_snapshots, kpi_alert_events, credit_transactions
Un KPI a cero puede ser un KPI sin datos
07 · Dashboards
Cuadros de Mando: la vista de cada departamento
Widgets de KPI, gráfico y tabla sobre una rejilla de 12 columnas, con filtros globales, comparación año anterior, cross-filter y modo kiosko.
/brain/dashboards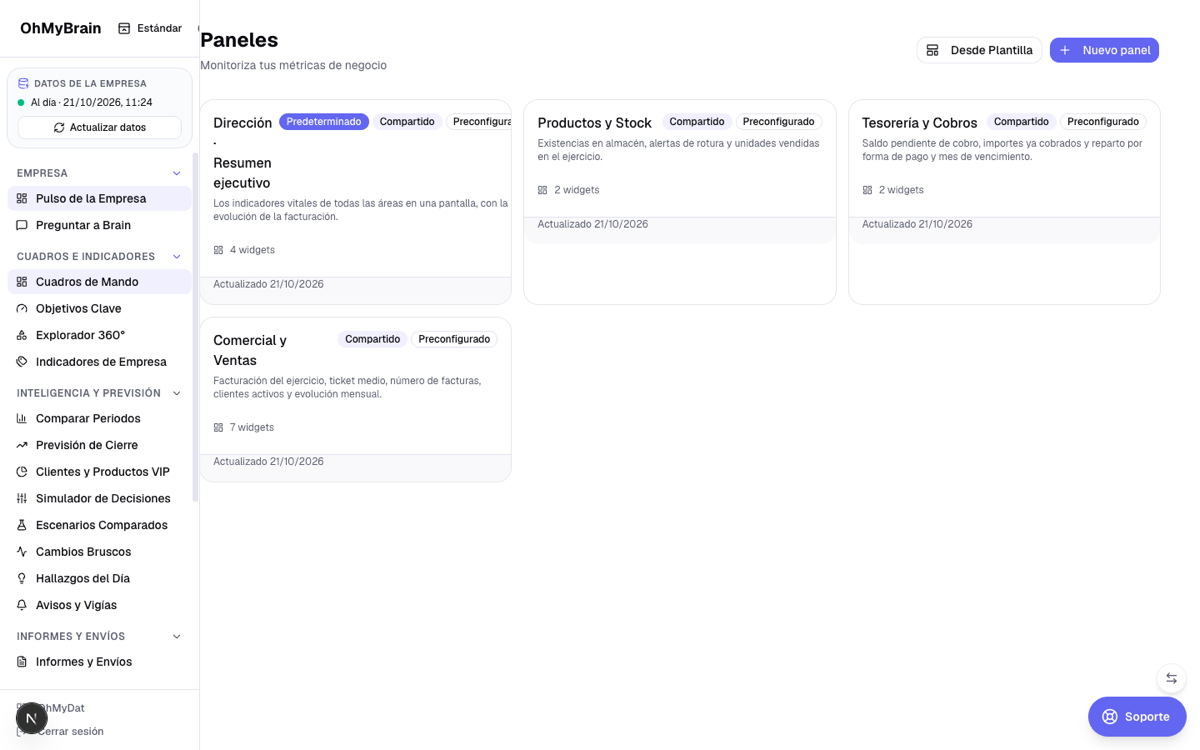
/brain/dashboards/[id]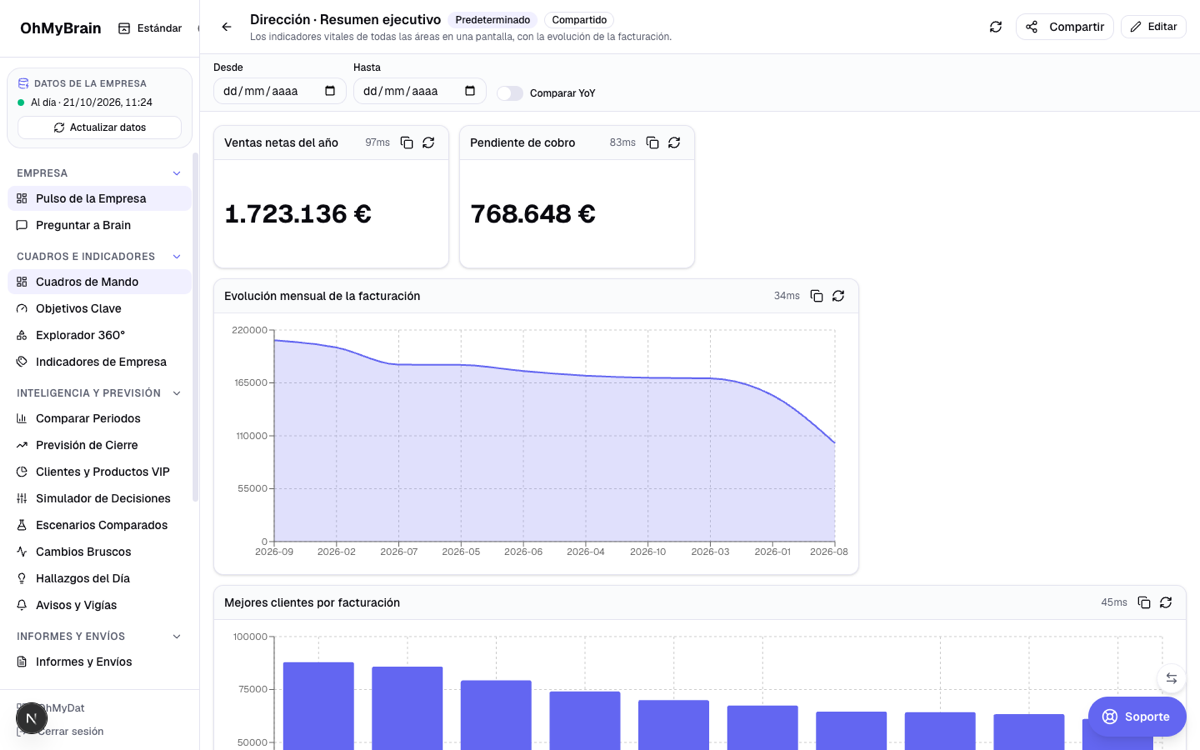
Filtros globales
La barra superior aplica fechas y «Comparar YoY» a todos los widgets del cuadro. Los filtros no se guardan en la URL: el enlace compartido abre el cuadro sin filtros.
Cross-filter y drill
Pulsa una barra, un tramo o una celda y los demás widgets se filtran por esa selección; vuelve a pulsar para soltar. El drill baja de nivel (año → trimestre → mes) sin salir del widget.
Añade y edita widgets
Cada widget se configura con indicador, desglose, periodo y tipo. Si el widget se construye desde el diálogo, el SQL se genera con el mismo constructor de negocio que el explorador: no se escribe SQL a mano.
Duplica antes de tocar lo compartido
Los cuadros preconfigurados llevan la etiqueta «Preconfigurado» y su dueño puede ser el sistema. Duplica y edita tu copia; el original lo usa más gente.
Modo kiosko TV
/brain/tv?dashboard=<id> rota los widgets a pantalla completa cada 15 segundos y refresca cada 5 minutos. Sin botones de edición: para la pantalla del almacén o la tienda. Añade &popup=1 para ocultar el menú lateral.
De dónde salen estos datos
BRAIN_QUERY_TIMEOUT_MS. Los packs preconfigurados no son SQL a mano: se generan desde el catálogo canónico con construirSqlDesdeConfigNegocio, la misma rutina del editor visual.- API
- GET /api/dashboards · POST /api/dashboards/[id]/widgets · POST /api/widgets/[id]/execute · GET /api/dashboards/predefinidos
- BD
- dashboards, dashboard_widgets
- Fichero
- artefacto .duckdb (cada widget ejecuta su SQL)
Widget vacío después de filtrar
08 · Análisis
Inteligencia y previsión: siete formas de mirar los mismos datos
Todos los análisis corren contra la copia extraída, avisan de la ventana real de datos y permiten guardar el resultado como escenario para revisitarlo.
Comparar Periodos
Dos periodos o dos segmentos cara a cara con la misma métrica. La comparación se hace en SQL (no restando dos capturas de pantalla), así que los dos lados usan exactamente la misma fórmula.
/brain/analysis/compare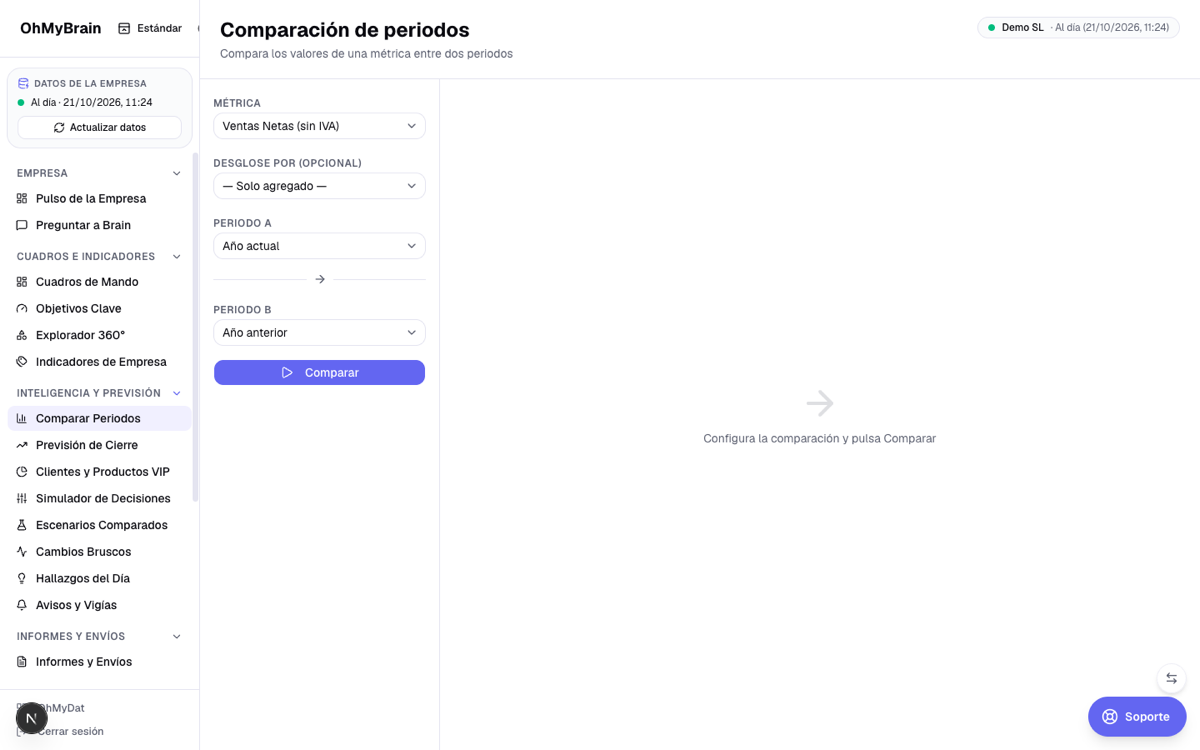
Previsión de Cierre
Pronóstico con Holt-Winters (suavizado triple con estacionalidad) y bandas de confianza del 80 % y 95 %. No devuelve un número solo: devuelve la horquilla y un backtest honesto (MAE y MAPE) sobre el histórico.
/brain/analysis/forecast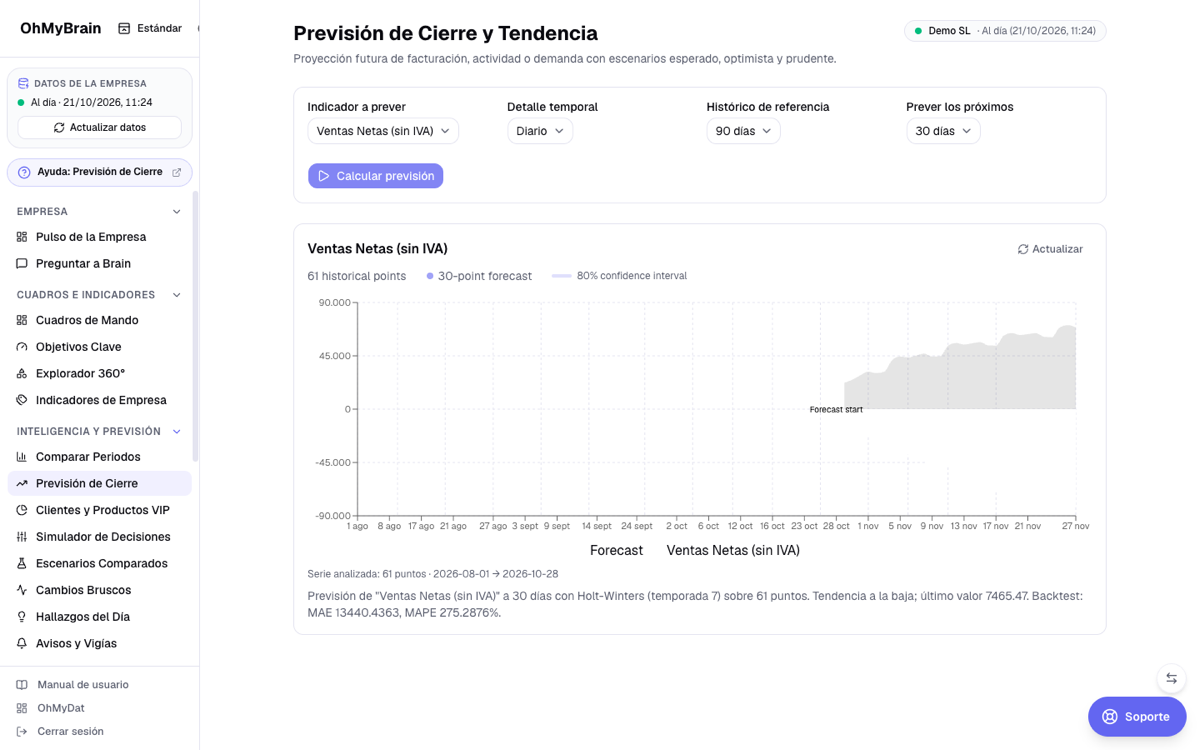
La ventana se ancla al final de los datos
La serie no se construye con NOW(): se ancla a MAX(fecha) de la tabla base. Si la copia tiene 20 días, «últimos 90 días» significa los 90 días anteriores al último documento, no los 90 anteriores a hoy. Si no hay puntos suficientes (mínimo 7), el mensaje dice el rango real disponible en vez de inventar una línea.
Clientes y Productos VIP
Clasificación ABC/Pareto (el 80 % del valor en el segmento A, el 15 % en B, el 5 % en C) y segmentación RFM por quintiles de recencia, frecuencia e importe. Sirve para responder «¿qué 20 % de clientes sostiene el negocio?».
/brain/analysis/segments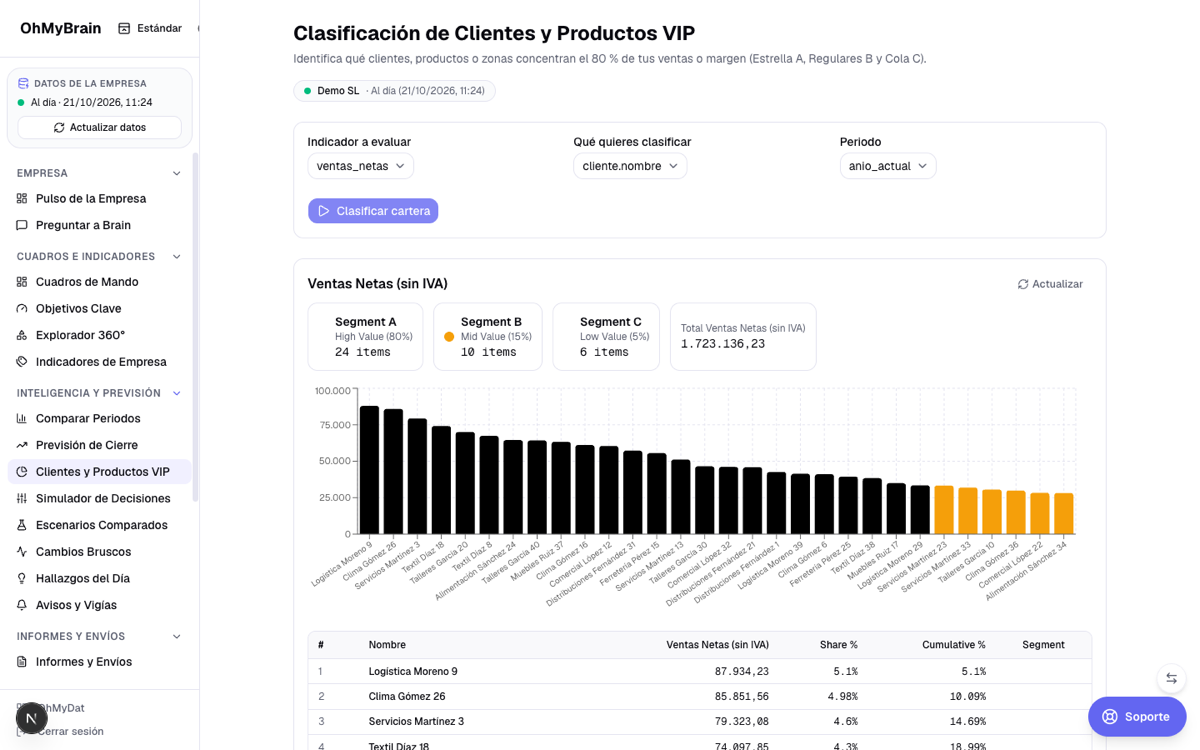
Simulador de Decisiones (what-if)
Simula escalas o fórmulas propias sobre una métrica. No escribe nada: el resultado es un cálculo efímero que, si convence, se guarda como escenario. La fórmula manual solo admite expresiones agregadas y aritméticas simples (nada de subconsultas ni comentarios).
/brain/analysis/what-if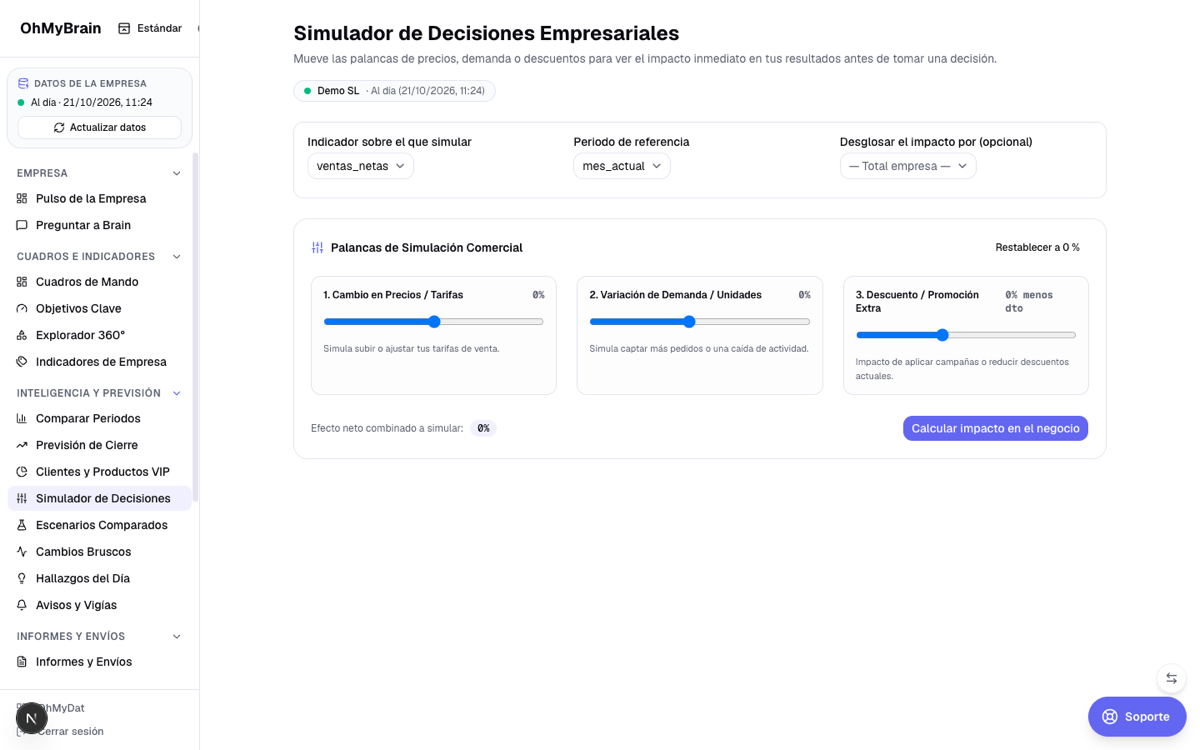
Escenarios Comparados
Cada análisis (previsión, anomalía, what-if, cohorte, embudo, ABC, RFM, comparación) se puede guardar como escenario con sus parámetros, su resultado y la huella del SQL. Dos escenarios se abren en paralelo para ver qué cambió entre una simulación de enero y la de hoy.
/brain/analysis/escenarios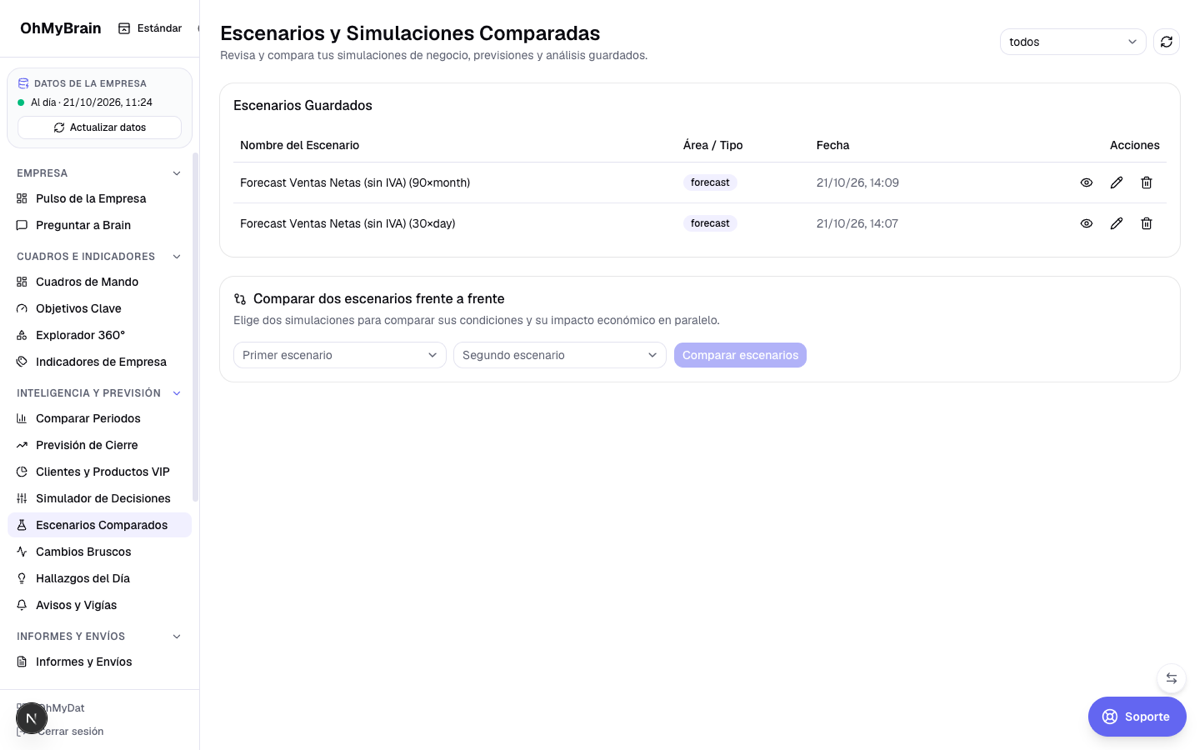
Cambios Bruscos (anomalías)
Descompone la serie (tendencia + estacionalidad), calcula el residuo y marca los puntos que se alejan más de z desviaciones (2,5 por defecto). No basta con el pico: la estacionalidad explica el lunes rutinario, así que no sale como anomalía.
/brain/analysis/anomalies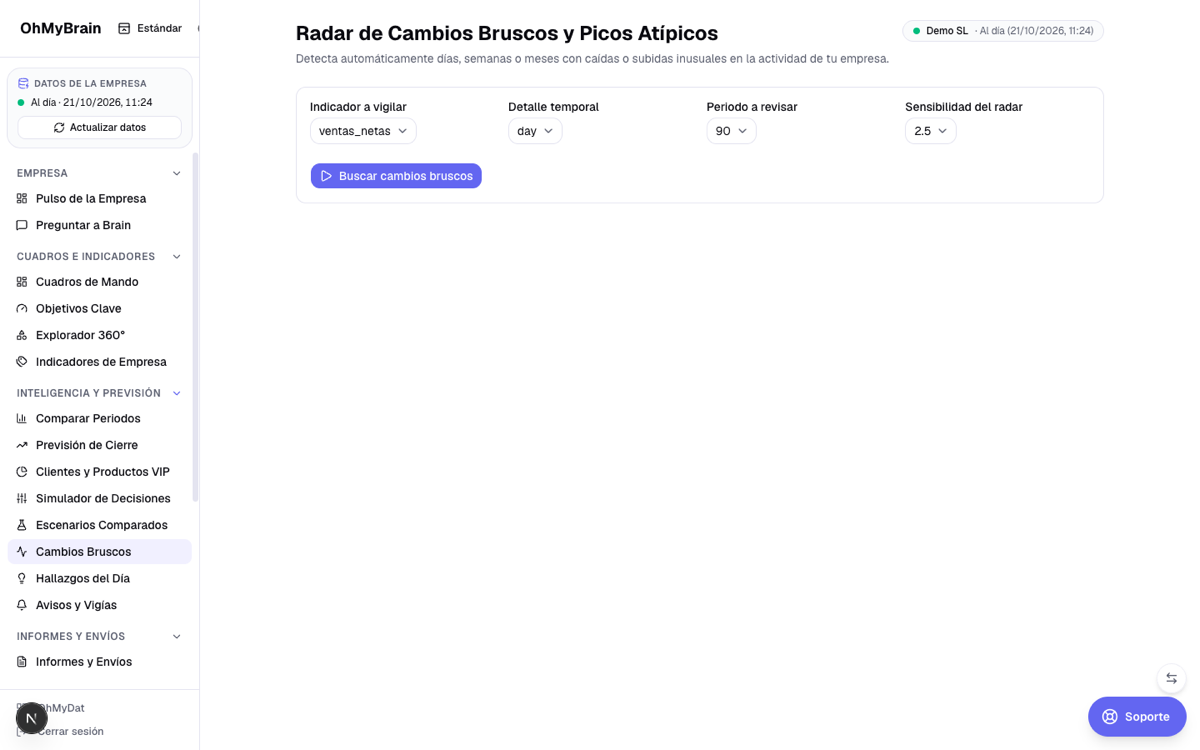
Hallazgos del Día
El feed de observaciones guardadas. No es un chat ni una IA que opina: cada hallazgo lo ha generado un análisis (previsión, anomalía, ABC…) y queda con su severidad, su tipo y su enlace al escenario. «Refrescar» borra los no descartados para que el siguiente ciclo los regenere.
/brain/analysis/insights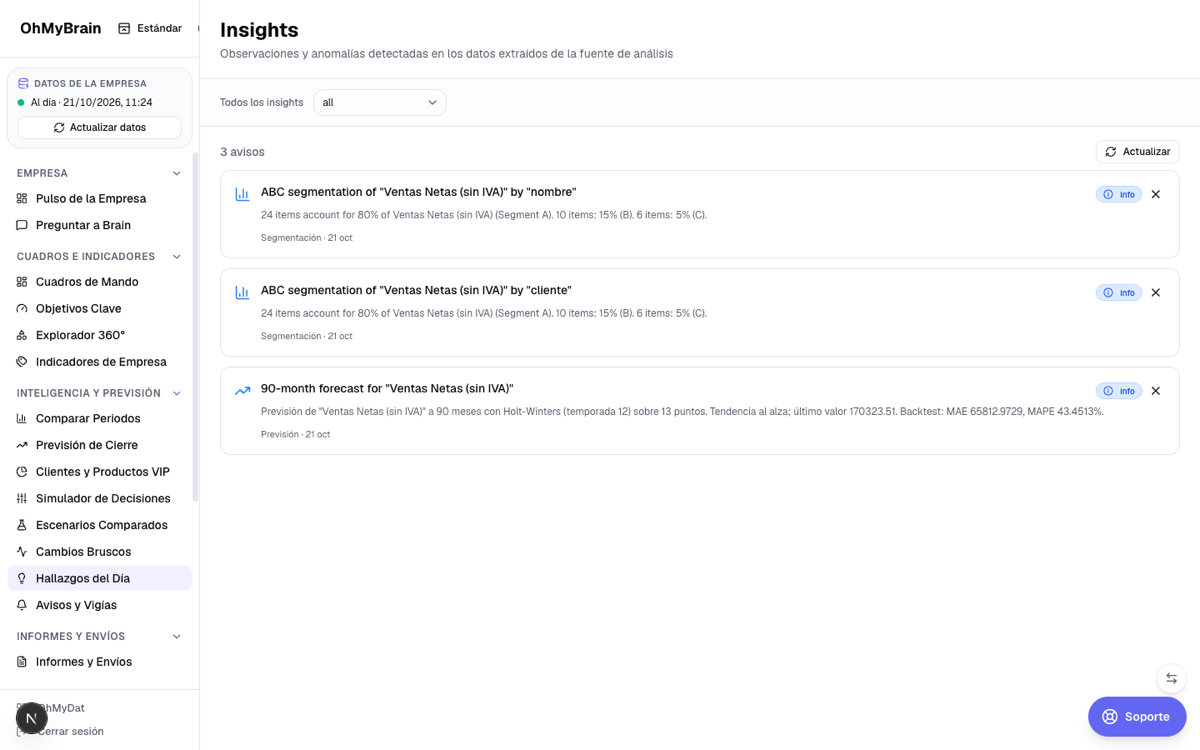
De dónde salen estos datos
series.ts): el modelo de lenguaje solo redacta la narrativa, no los números. Guardar un escenario persiste params_json, resultado_json y sql_hash en brain_analysis_scenarios, así que un resultado de hace un mes sigue siendo legible aunque la copia haya cambiado.- API
- POST /api/analysis/compare · /comparar · /forecast · /anomalies · /segments · /abc · /cohortes · /funnel · /what-if · /correlation · GET /api/scenarios
- BD
- brain_analysis_scenarios, insights, kpi_snapshots
- Fichero
- artefacto .duckdb (SQL calculado en el momento)
09 · Vigilancia
Avisos y Vigías: reglas que miran por ti
Una regla vigila un KPI, la frescura de la copia, la calidad del dato o una anomalía, y avisa por la campana del panel, por email o por ambos.
/brain/alertas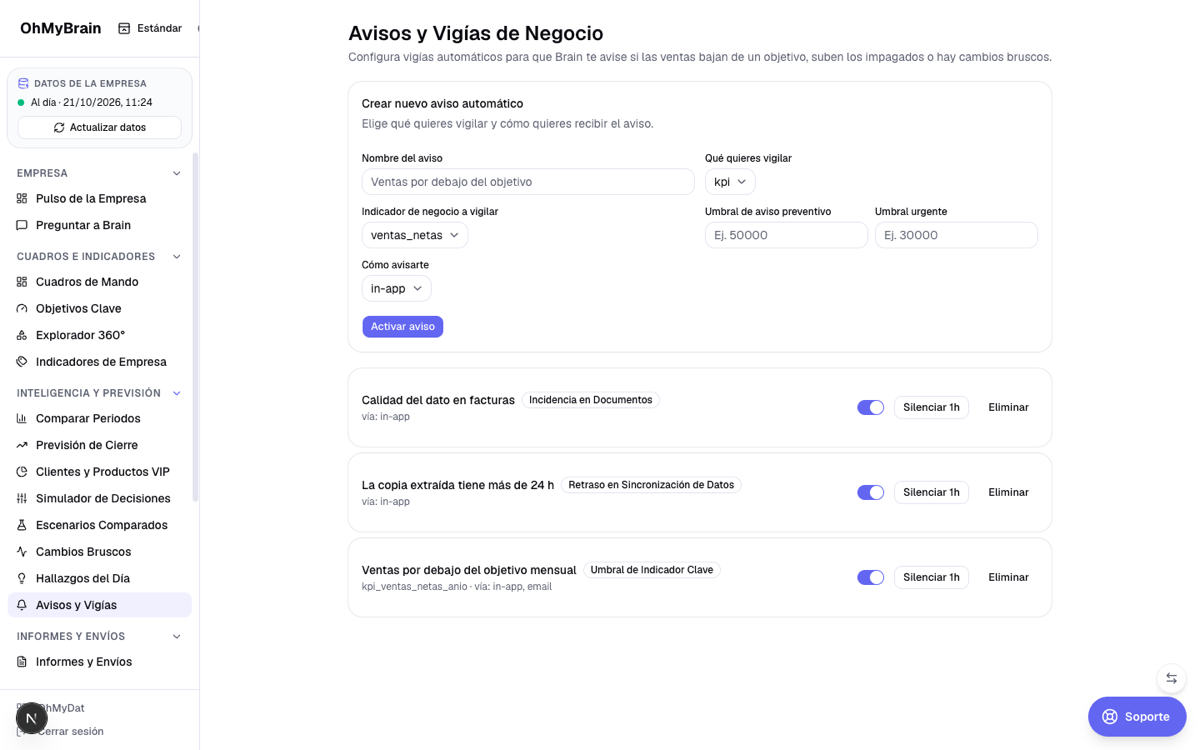
Elige qué vigilar
KPI (un umbral sobre el último snapshot), frescura (la copia supera el SLA, 24 h por defecto), DQ (el último chequeo es crítico) o anomalía (hay un evento sin acusar en 24 h).
Define umbrales y canal
Warning y critical; la dirección decide si subir o bajar es bueno. Canales: in-app (campana), email o ambos. Los emails llevan digest y un máximo de 5 por empresa y día.
Silencia sin borrar
«Silenciar 1 h» pausa la regla el tiempo indicado (hasta 7 días). Al vencer vuelve sola. Útil en vacaciones, cierres o durante una migración.
Revisa las entregas
Cada disparo deja un registro con el canal final usado, el estado (enviada, digest, fallida) y el detalle. Si un email no llega, el registro dice si se intentó y qué pasó.
De dónde salen estos datos
BRAIN_SCHEDULER_MIN). Para KPI lee el último snapshot y aplica el mismo semáforo que la ficha; para frescura compara lastExtractedAt con el SLA; para DQ lee el último chequeo; para anomalía busca eventos sin acusar. Hay un cooldown de 60 minutos por regla para no repetir el mismo aviso en cada pasada y un digest de 5 emails al día por empresa.- API
- GET/POST /api/alertas · GET /api/alerts/events · GET /api/alerts/unread-count
- BD
- brain_alert_rules, brain_alert_deliveries, kpi_snapshots, brain_data_quality, connectors
- Fichero
- — (la regla consulta snapshots y estados ya calculados)
La campana no es el email
10 · Comunicar
Informes, presentaciones y envíos
Del dato a la reunión: informes con secciones y PDF, presentaciones narradas y suscripciones de resumen periódico.
Informes ejecutivos
Un informe es un conjunto de apartados con nombre y SQL que se ejecutan juntos contra la copia. Se exporta en PDF, CSV, Excel o JSON, se programa con cron y se envía a los destinatarios. El histórico de generaciones guarda estado, duración, error y descarga.
/brain/reports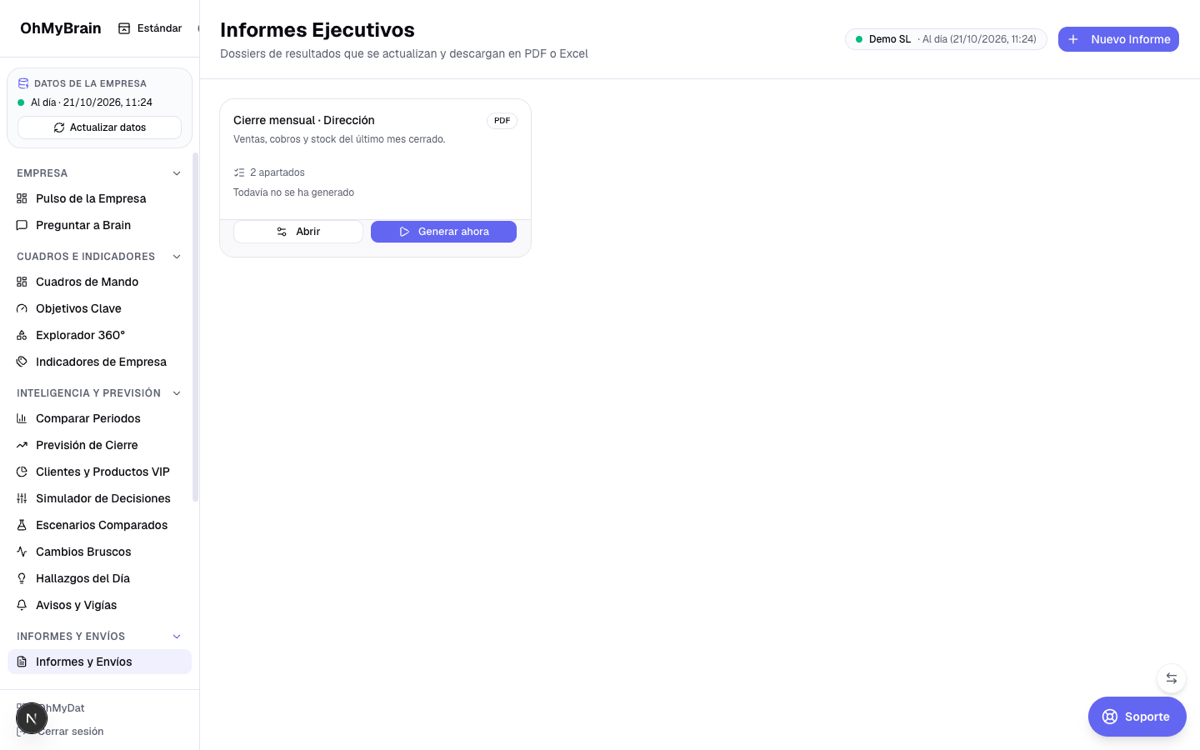
/brain/reports/[id]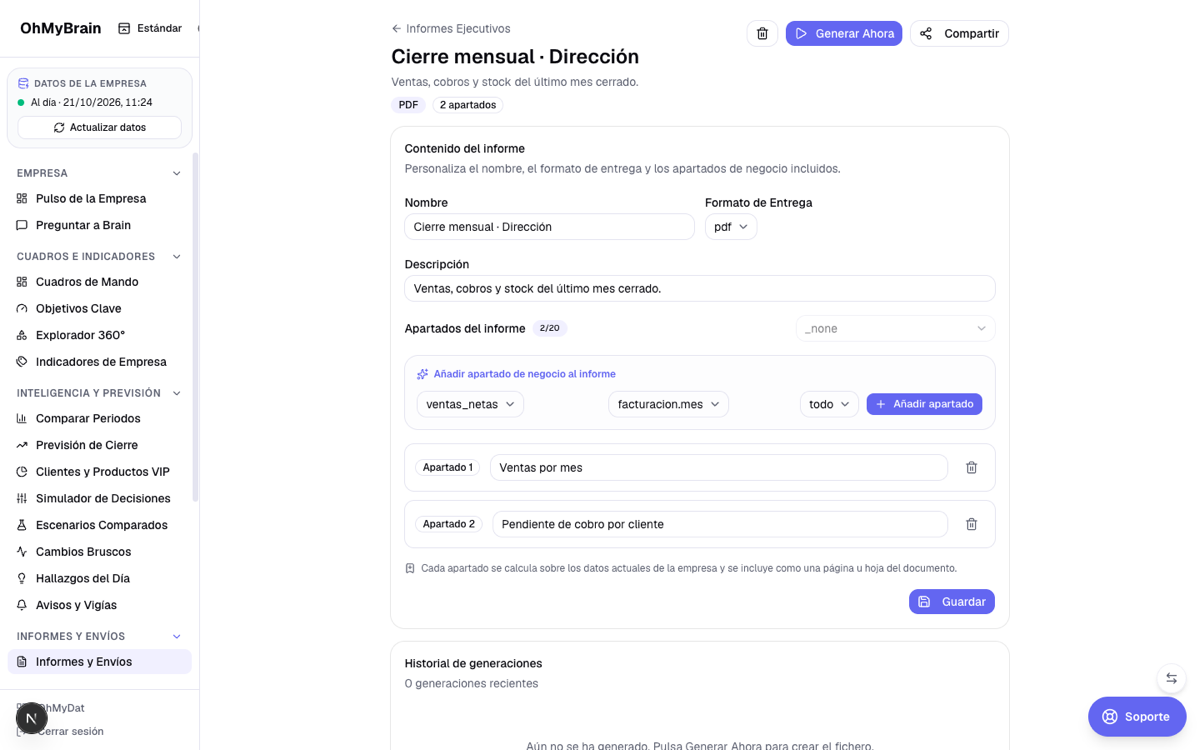
Presentaciones
Diapositivas para contar en reunión: texto, KPI, gráfico, tabla y decisión. «Insertar datos reales» rellena la diapositiva con el indicador elegido; el resultado se presenta a pantalla completa o se descarga en PDF.
/brain/presentaciones/[id]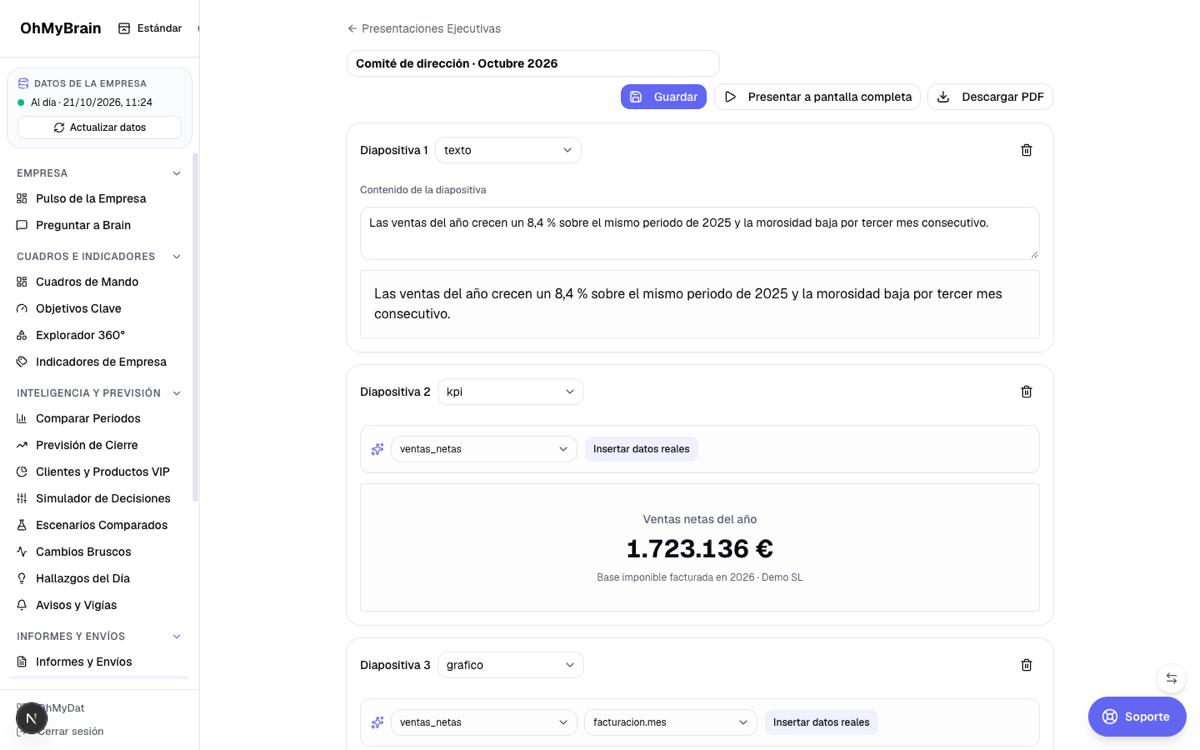
Envíos por Correo
Suscripción a un cuadro o a un informe con una cadencia cron (el clásico: lunes a las 8:00 con la semana anterior), destinatarios y formato. La suscripción queda registrada y visible en el panel.
/brain/suscripciones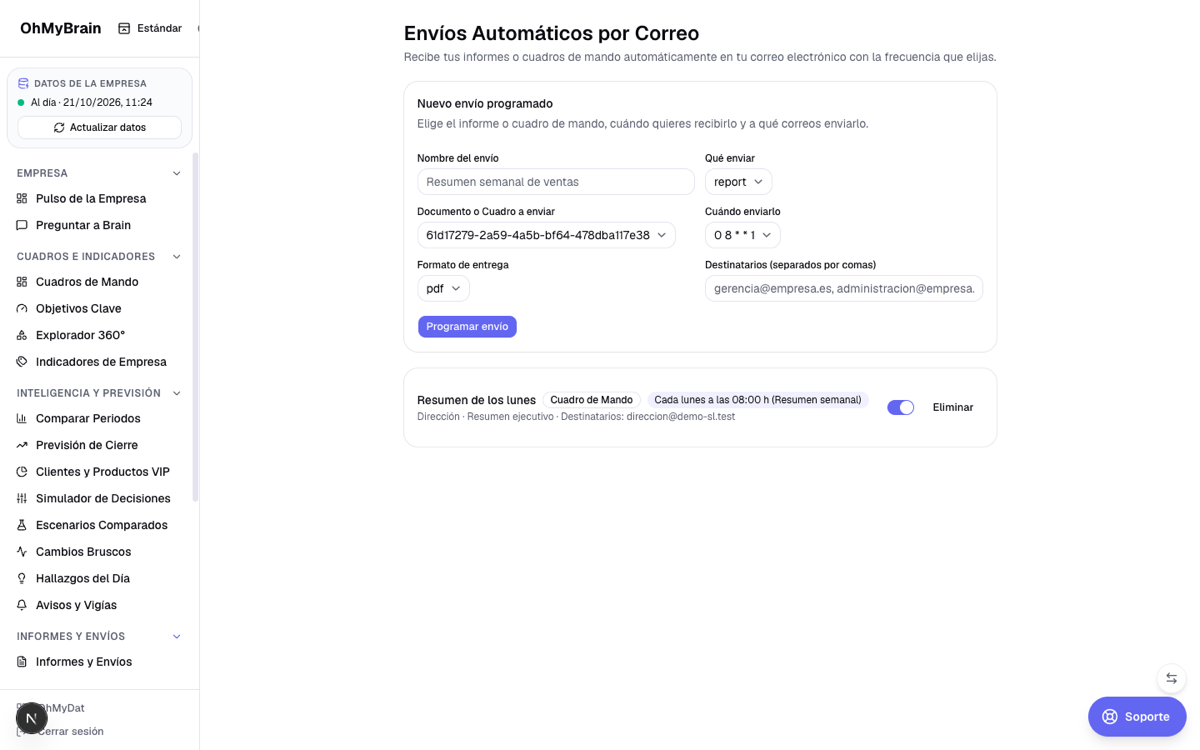
Hoy el envío automático de suscripciones no está programado
De dónde salen estos datos
report-scheduler.ts) revisa los informes activos cada pasada y encola los que tocan según su cron y sus destinatarios. El worker ejecuta cada apartado contra el DuckDB, corta a 500 filas por sección en el PDF y escribe el artefacto en uploads/reports/…; en la base de datos solo queda la ruta, no el binario. Las presentaciones y suscripciones se persisten en sus tablas y no copian datos: los bloques se rellenan al insertar el indicador.- API
- GET/POST /api/reports · POST /api/reports/[id]/executions · GET /api/presentations · POST /api/presentations/[id]/export-pdf · GET/POST /api/suscripciones
- BD
- reports, report_executions, brain_presentations, brain_subscriptions
- Fichero
- uploads/reports/<tenant>/<ejecución>.<pdf|csv|xlsx|json>
11 · Origen
Datos, fuentes y calidad: el capítulo que explica el resto
Cómo se elige la fuente, cómo se extrae, cómo se firma la copia, qué es la frescura y qué significa que la calidad salga roja.
Fuente de análisis
Un solo conector marcado. Si marcas otro, el anterior se desmarca.
Modos
OhMyExtract (recomendado) o consulta directa del conector en instalaciones antiguas.
Artefacto
Un .duckdb por extracción, con nombre fechado; nunca se sobrescribe el anterior.
Firma
SHA-256 guardado en la BD. Si el fichero no coincide, no se abre: se re-descarga o se re-extrae.
Caché local
La primera lectura descarga a uploads/extracted con rename atómico; las siguientes reutilizan.
Purga
LRU por tamaño (BRAIN_EXTRACT_MAX_MB) y antigüedad (BRAIN_EXTRACT_MAX_DIAS).
Salud de la fuente y estados
| Estado | Qué significa | Qué hacer |
|---|---|---|
| success (verde) | Copia lista y firmada. | Nada; mira la frescura. |
| running (ámbar) | Extrayendo ahora. | Espera; no relances encima. |
| pending (ámbar) | En cola. | Espera al worker. |
| failed (rojo) | La extracción falló. | Lee el error, revisa credenciales/red y relanza. |
Frescura y calidad del dato (DQ)
Cada pantalla de datos muestra cuándo se extrajo y un semáforo de calidad calculado con reglas base sobre la copia: nulos inesperados, duplicados de identificador, negativos imposibles, fechas futuras (las cuatro reglas base: pk_duplicada, nulos_prohibidos, negativos_imposibles y fechas_futuras). La DQ no bloquea la lectura: informa. La decisión de fiarte es tuya, pero que sea consciente.
Si la DQ sale roja, no discutas el gráfico
Abre el explorador y mira qué regla falla, en qué tabla y columna y cuántas filas la violan. El detalle está en el perfil de la extracción.
Decide si es origen o plantilla
Si el ERP tiene duplicados reales, se corrige en el ERP y la próxima extracción los trae limpios. Si el mapeo está mal, se corrige en la plantilla de conversión del conector.
Automatiza el aviso
Crea una regla de tipo dq en Avisos y Vigías para que te avise cada vez que el chequeo salga crítico.
Subir un CSV suelto
/brain/connectors/upload permite incorporar una tabla sin conector. Pasa la misma validación de tipo y contenido que el resto antes de entrar en la copia.
Diferencia entre extracciones
brain_extraction_diffs guarda qué cambió entre dos copias (tablas, filas, altas y bajas) para explicar por qué un número se movió sin que nadie tocara la fórmula.
De dónde salen estos datos
status = active, extract_mode = ohmyextract, extract_enabled, last_extract_status = success y last_extract_s3_uri presente. El artefacto se verifica contra last_extract_sha256 antes de abrirlo; si no coincide, se invalida la caché, se re-descarga una vez y, si sigue fallando, se responde 409 pidiendo re-extracción. La purga programada borra artefactos antiguos sin tocar los vigentes.- API
- GET /api/connectors · GET /api/connectors/health · GET /api/connectors/[id]/extractions · POST /api/connectors/[id]/extract · GET /api/profiling · GET /api/calidad
- BD
- connectors, extract_jobs, connector_tables, field_mappings, brain_data_profiles, brain_data_quality, brain_extraction_diffs
- Fichero
- S3 (o file:// en demo) · uploads/extracted/<clave>.duckdb · manifest de firma
No borres ficheros de uploads a mano
12 · Fuera del panel
Compartir y API pública: enseñar sin abrir la puerta
Enlaces firmados con caducidad y revocación, widgets embebibles y una API pública con clave por empresa. El receptor ve el dato, nunca el conector ni las credenciales.
Compartir un cuadro o un informe
El botón Compartir genera un token opaco de 64 caracteres hexadecimales (aleatorio, sin información embebida), con caducidad opcional (de 1 hora a 90 días) y revocación inmediata. El enlace se sirve en /api/share/<token>?empresa=<slug>.
Qué ve el destinatario
Solo el recurso y los campos blanqueados: nombre, configuración y datos. Nunca el conector, la URI de S3, los dueños ni las credenciales. Si el token caduca o se revoca, devuelve 404.
Widget y KPI públicos
GET /api/public/widget?id=<widgetId> y POST /api/public/kpi (body { sql }) se sirven sin sesión con la cabecera x-brain-key: <tenantDbName>.<hmac>. Sin clave configurada (BRAIN_PUBLIC_KEY o huella en el tenant), la API responde 404: desactivada por defecto.
Prueba siempre en incógnito
Abre el enlace compartido en una ventana privada: lo que veas ahí es exactamente lo que verá el destinatario, sin tu sesión ni tus permisos.
La API pública no es un SQL libre
El KPI público recibe SQL, pero pasa el mismo guard SELECT-only que el chat y el playground: una sentencia, solo lectura, funciones en lista blanca y timeout de 15 segundos. Además está limitada a 60 peticiones por hora y por IP. La clave identifica a la empresa; no otorga permisos de escritura.
De dónde salen estos datos
brain_share_links guarda el token, el tipo y el id del recurso, la caducidad, el alcance y el dueño. La API pública resuelve el tenant desde la clave y comprueba el HMAC contra la huella guardada; después ejecuta el widget o el SQL con fuentePublica(), que aplica el mismo criterio de fuente de análisis. El payload de respuesta se limita a 500 filas.- API
- POST /api/share · GET /api/share/[token] · GET /api/public/widget · POST /api/public/kpi
- BD
- brain_share_links, dashboard_widgets, connectors (solo para resolver la fuente), AiProviderConfig.settings.publicKey
- Fichero
- artefacto .duckdb (el enlace ejecuta el SQL del widget con el guard)
Compartir no es publicar
13 · Contexto
Conocimiento y playground: documentos, plantillas y SQL gobernado
Los datos no lo explican todo. Documentos, plantillas y consultas guardadas dan contexto; el playground permite SQL fino sin saltarse el guard.
Documentos
PDF, Word, Excel, CSV y texto. Se trocean, se extrae el texto y se indexan embeddings si hay proveedor de IA.
Plantillas
Consultas parametrizadas con versión, categoría y validación contra tablas y métricas.
Consultas guardadas
Preguntas del chat con nombre y dueño, reutilizables y ejecutables.
Sube el contexto que falta
/brain/documentsContratos, pliegos, actas, tarifas. El chat los cita como fuentes cuando activas «Solo documentos adjuntos» o cuando combinas datos y documentos. Sin proveedor de IA, la búsqueda sigue en modo léxico: nunca se simula una respuesta.
Guarda una pregunta útil
/brain/queriesLa pregunta se guarda con nombre, dueño y versión. Se puede ejecutar de nuevo, convertir en plantilla o insertar en un informe.
Usa una plantilla del equipo
/brain/templatesLas plantillas admiten parámetros ({{zona}}, {{mes}}), validan tablas y métricas y se duplican antes de adaptarlas. La original la usa más gente.
Baja al SQL en el playground
/brain/playgroundEditor para quien sabe SELECT: misma fuente, mismo guard, validación contra el esquema real, paginación de 100 en 100, exportación CSV y guardado como métrica, KPI o informe.
/brain/playground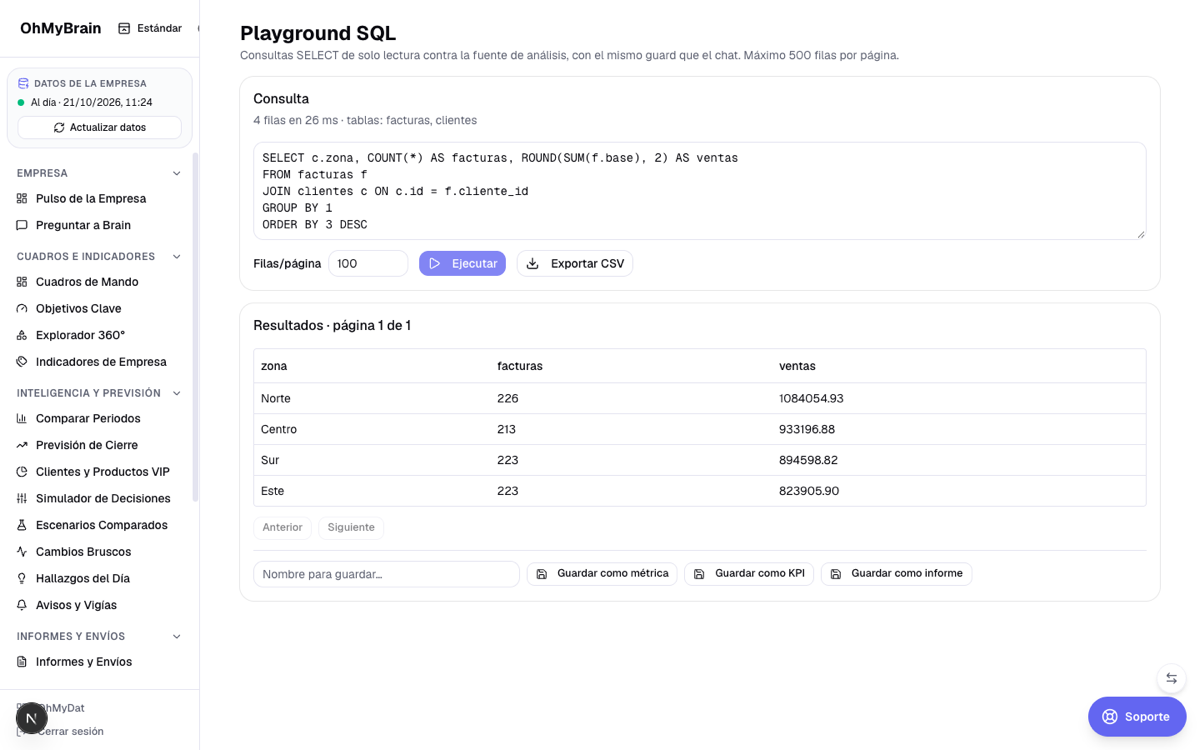
El guard también está aquí
De dónde salen estos datos
ejecutarSelectFuente, pagina en memoria y registra telemetría muestreada (1 de cada 10 ejecuciones) en brain_query_log, que es lo que alimenta el linaje.- API
- POST /api/documents/upload · GET/POST /api/queries · GET/POST /api/query-templates · POST /api/playground/execute
- BD
- documents, embeddings, saved_queries, query_templates, brain_query_log
- Fichero
- uploads/documents/… · embeddings en la BD del tenant
14 · Permisos
Equipo y permisos: quién puede ver, editar y compartir
Tres roles de empresa, un dueño por recurso y un canEdit que la interfaz respeta. Sin letra pequeña.
/brain/settings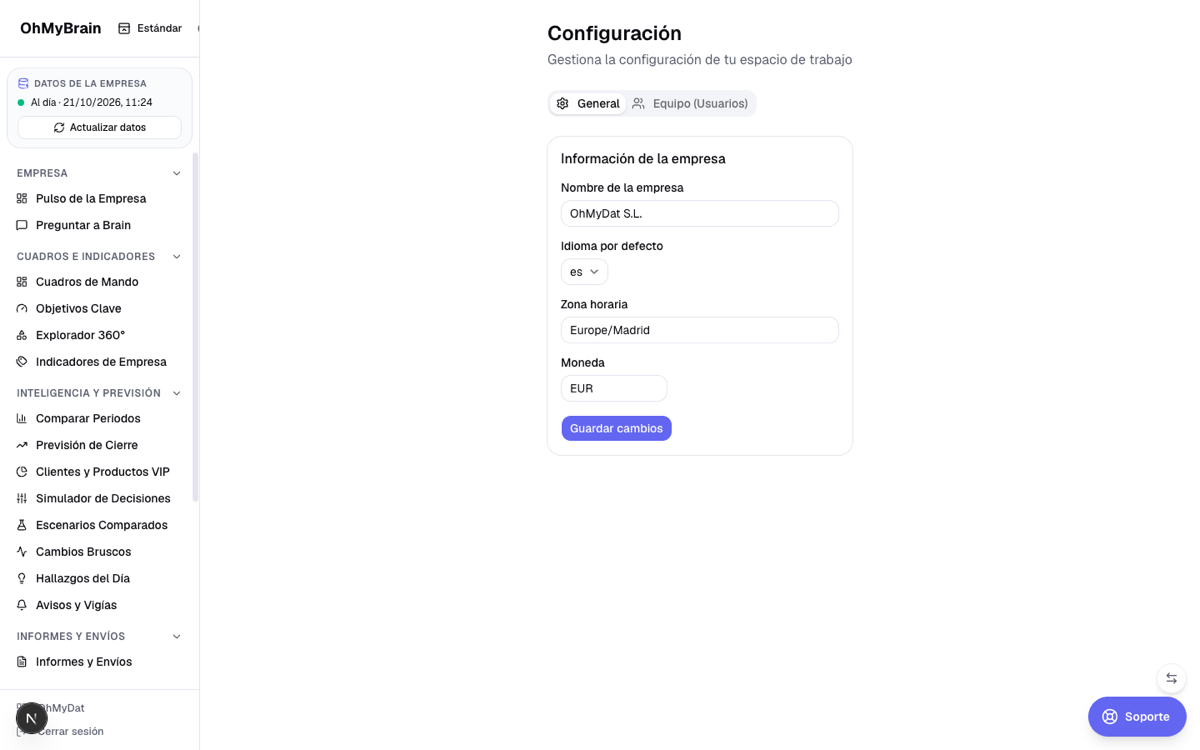
| Rol | Puede | No puede |
|---|---|---|
| admin | Todo: equipo, credenciales, fuentes, plantillas globales, recursos compartidos y borrado de lo ajeno. | — |
| analyst (por defecto) | Crear y editar lo suyo, consultar la fuente de análisis compartida, ejecutar SQL y refrescar KPIs. | Cambiar credenciales, borrar recursos del sistema o tocar lo de otro. |
| viewer | Leer lo que tiene permiso de ver. | Editar, ejecutar consultas o compartir. |
Dueño (ownerId)
Quien creó el recurso. Lo edita su dueño o un admin. Los recursos del sistema (ownerId nulo, por ejemplo los cuadros preconfigurados) solo los toca un admin. Duplicar es la forma correcta de adaptarlos.
canEdit
La API calcula por recurso si puedes mutarlo y la interfaz desactiva los botones que tu rol no permite. Si un botón sale desactivado, no es un error: es tu rol.
De dónde salen estos datos
canWriteBrain / isBrainAdmin en cada ruta. La lectura de datos de un conector privado exige ser su dueño o admin; la fuente de análisis compartida la consulta cualquier rol de escritura. Los workers usan un usuario de sistema con rol analyst: nunca actúan como administrador.- API
- GET/PATCH /api/settings · GET/POST/PATCH/DELETE /api/settings/team · GET /api/auth/session
- BD
- tenant_users, empresa_identidad_modulos, empresa_miembros (master)
- Fichero
- —
El rol del hub y el rol del módulo
Ajustes del módulo que sí conviene conocer
Los valores viven en la sección OhMyBrain de /admin/configuracion. La procedencia del valor es: override de empresa → BD maestra → .env → defecto del catálogo. Los cambios se aplican al guardar; el tamaño del pool se toma al abrir la siguiente instancia de lectura.
| Clave | Defecto | Para qué la tocas |
|---|---|---|
| BRAIN_QUERY_TIMEOUT_MS | 30000 | Timeout de cada consulta; súbelo para informes muy pesados. |
| BRAIN_DUCK_POOL_SIZE | 4 | Lecturas concurrentes sobre la copia (más widgets a la vez). |
| BRAIN_EXTRACT_MAX_MB | 5120 | Cuánto disco puede ocupar la caché de artefactos. |
| BRAIN_EXTRACT_MAX_DIAS | 7 | Cuántos días se conserva un artefacto local. |
| BRAIN_PUBLIC_KEY | (vacío) | Activa la API pública; vacío = responde 404. |
| BRAIN_DEMO_ENABLED | true | Permite instalar Demo SL en la empresa. |
| BRAIN_SCHEDULER_MIN | 5 | Minutos entre pasadas de informes y alertas; la purga es diaria. |
15 · Ayuda
Errores frecuentes (y qué significan de verdad)
Al preguntar sale 409 «No hay fuente de análisis»+
No hay ningún conector marcado como fuente o el usuario no puede leerlo. Ve a Conexión de Datos, marca «Extracción de datos para análisis» y lanza la primera extracción. Si acabas de instalar la demo, vuelve a pulsar Instalar demo: la versión anterior no guardaba la marca de fuente.
Sale 409 «La fuente todavía no tiene una extracción DuckDB»+
Hay fuente, pero la última extracción no está en success o no tiene artefacto. Mira el estado y el error en la ficha del conector: credenciales, red, permisos o un job que falló. Relanza cuando lo hayas corregido.
Firma rota: 409 y no abre nada+
La copia local no coincide con el SHA-256 que guardó el job. Brain invalida la caché, re-descarga una vez y, si sigue sin coincidir, pide re-extracción. No manipules uploads/extracted a mano.
¿Por qué solo veo 500 filas o la tabla dice «truncado»?+
Es un tope anti-tablas gigantes: el hilo guarda 500 filas, el playground pagina de 100 en 100 y el PDF corta a 500 por sección. El cálculo (sumas, previsiones, ABC) usa los datos completos; el recorte es solo de presentación. Exporta el CSV para el resto.
El chat responde 503 «credencial rechazada» o «sin proveedor»+
Falta una clave de IA o el proveedor la rechaza. El mensaje dice la clave y la capa. Con CONFIG_FUENTE=bd, el valor del panel manda sobre el .env: corrige el del panel en /admin/configuracion → IA. Una clave de 10 caracteres no es una clave válida.
Un KPI sale a cero y la fórmula parece correcta+
Comprueba el periodo (año actual / mes actual) contra el último dato de la copia. Si la extracción termina en diciembre, en enero el KPI de año actual vale cero. Mira lastExtractedAt antes de tocar la métrica.
La previsión dice «datos insuficientes»+
Necesita al menos 7 puntos con el detalle elegido. La ventana se amplía sola hasta 7 periodos, pero si la tabla no tiene histórico suficiente no hay nada que pronosticar. El mensaje muestra el rango real (desde/hasta) de la tabla base.
La calidad del dato sale roja: ¿puedo seguir usando los números?+
Sí, la DQ informa pero no bloquea. Abre el catálogo, mira qué regla falla y decide si es un problema de origen (se corrige en el ERP) o de mapeo (se corrige en la plantilla). Si vas a usar el dato en una decisión, no lo ignores.
Un KPI no se actualiza solo aunque pasen los días+
El worker de KPIs no tiene una pasada periódica: calcula cuando pulsas «Actualizar cifra» o «Calcular todos», o cuando tu automatización llama a /api/kpis/refresh-all. El scheduler revisa informes, alertas y purga, pero no recalcula KPIs. Si necesitas el valor fresco cada mañana, programa ese refresh en tu automatización o pulsa Calcular todos al abrir el panel; el aviso de KPI usa el último snapshot disponible.
¿Por qué mi suscripción no envía correos?+
Hoy las suscripciones se guardan pero el scheduler no las procesa: no hay worker de envío de suscripciones. Usa un informe programado con destinatarios para el envío automático; la suscripción queda como configuración prevista.
Compartí un enlace y ahora devuelve 404+
El token caducó o se revocó. Vuelve a generarlo desde Compartir. Los enlaces no se pueden reactivar: se crean de nuevo.
La API pública responde 404 «API pública desactivada»+
No hay clave configurada. Define BRAIN_PUBLIC_KEY en Configuración del entorno o guarda la huella en el tenant, y envía x-brain-key con el formato <tenantDbName>.<hmac>.
Un widget sale vacío después de filtrar+
El cross-filter de otro gráfico sigue activo. Quita la selección en la barra de filtros o pulsa de nuevo la barra/celda que activaste.
16 · Anexo
De dónde sale cada número: tabla de trazabilidad
Resumen de una página para llevar a una revisión técnica o a una auditoría. Toda pantalla de datos termina en el mismo sitio: el artefacto DuckDB de la última extracción.
| Pantalla | API | Lee de | Calcula en |
|---|---|---|---|
| Pulso | /api/catalogo/explorar?modo=pulso | DuckDB + catálogo canónico | SQL en el artefacto |
| Preguntar | /api/ai/chat | threads, thread_messages | LLM → guard → DuckDB |
| Explorador | /api/catalogo, /api/catalogo/explorar | DuckDB, _resumen_extraccion | SQL en el artefacto |
| Indicadores | /api/semantic/models | brain_semantic_*, catálogo | — (definiciones) |
| Objetivos | /api/kpis, /api/kpis/snapshots | plantilla + kpi_snapshots | Worker KPI → DuckDB |
| Cuadros | /api/widgets/[id]/execute | dashboards, dashboard_widgets | SQL del widget → DuckDB |
| Previsión | /api/analysis/forecast | catálogo + DuckDB | Holt-Winters en servidor |
| Anomalías | /api/analysis/anomalies | catálogo + DuckDB | STL + z-score en servidor |
| ABC/RFM | /api/analysis/segments, /abc | catálogo + DuckDB | Pareto/quintiles en servidor |
| What-if | /api/analysis/what-if | catálogo + DuckDB | SQL simulado, sin escritura |
| Escenarios | /api/scenarios | brain_analysis_scenarios | — (resultado guardado) |
| Hallazgos | /api/insights | insights | Generados por los análisis |
| Avisos | /api/alertas, /api/alerts/events | brain_alert_rules, brain_alert_deliveries | Worker de alertas |
| Informes | /api/reports, /executions | reports, report_executions | Worker de informes → DuckDB |
| Presentaciones | /api/presentations | brain_presentations | Datos insertados al editar |
| Envíos | /api/suscripciones | brain_subscriptions | Sin worker de envío (ver cap. 10) |
| Compartir | /api/share, /api/public/* | brain_share_links | SQL con guard (público) |
| Documentos | /api/documents/upload | documents, embeddings | Texto + embeddings |
| Playground | /api/playground/execute | DuckDB + brain_query_log | SQL con guard |
| Ajustes/equipo | /api/settings, /api/settings/team | tenant_users | — |
Reglas de oro de la trazabilidad
- Toda lectura pasa por
abrirFuenteAnalisis: misma descarga, misma firma, mismo pool. - Toda ejecución pasa por
validarSelectDuck: una sentencia, solo lectura, funciones permitidas. - La frescura es
connectors.lastExtractedAt, no la hora del navegador. - El linaje es
brain_query_logporsql_hash; si no hay registro, el diálogo enseña el contexto recibido. - Los escenarios guardan parámetros, resultado y huella: un número de hace un mes sigue siendo explicable.
Sobre las capturas de este manual
Están hechas sobre la empresa de demostración con la fuente Demo SL: clientes, productos, facturas y personas son inventados. No se ha capturado ninguna empresa real ni ningún dato de cliente. Las cifras sirven para reconocer la pantalla, no como ejemplo de negocio.
¿Te falta un caso? El manual de OhMyDat explica el alta de empresa y la contratación del módulo; el resto de módulos tienen su propia guía en Manuales de usuario. Para incidencias, abre un ticket desde OhMySupport o escríbenos desde Contacto.
Abrir esta guía en el navegador ·Volver a Pulso de la Empresa